tutos · vidéo ia · comfyui
Générer des vidéos IA avec le son en local sur une RTX 5070 Ti 16 Go avec LTX-2.3
LTX-2.3, le modèle open source de Lightricks, génère la vidéo et le son dans le même passage : voix, bruitages, ambiance. Sur une carte de joueur de 16 Go, il tourne en local dans ComfyUI, sans nœud custom, à condition d'utiliser la bonne version du modèle et d'avoir assez de RAM. Voici la méthode exacte, avec les temps mesurés.
La config testée
- Carte graphique : NVIDIA RTX 5070 Ti, 16 Go de VRAM (architecture Blackwell).
- RAM : 64 Go. C'est le point non négociable, voir plus bas.
- Logiciel : ComfyUI installé via Stability Matrix 0.21 ou plus récent. Sur une carte Blackwell, PyTorch doit être compilé pour CUDA 12.8 ou plus.
- Nœuds custom : aucun. Tout ce qui suit utilise les nœuds natifs de ComfyUI.
- Disque : prévoyez environ 40 Go pour les modèles, idéalement sur un SSD.
Pourquoi 64 Go de RAM
Le modèle pèse 29,5 Go et l'encodeur de texte 9,5 Go : ensemble, ils ne tiennent pas dans 16 Go de VRAM. ComfyUI s'en sort grâce à son chargement dynamique : il garde les poids en RAM et les envoie vers la carte graphique au fur et à mesure du calcul.
Deux conséquences pratiques :
- La VRAM est pleine en permanence pendant le rendu, et c'est normal. Ce n'est ni une fuite mémoire ni le signe d'un plantage imminent.
- La RAM fait le gros du travail de stockage. J'ai mesuré un pic d'environ 60 à 62 Go. Avec 32 Go, ça ne passe pas.
Étape 1 : télécharger les trois modèles
On utilise la version distillée en FP8 : elle génère en 8 pas au lieu d'une trentaine, et sa précision réduite la rend gérable sur une carte grand public.
| Fichier | Taille | Dépôt Hugging Face | Dossier ComfyUI |
|---|---|---|---|
ltx-2.3-22b-distilled-fp8.safetensors | 29,5 Go | Lightricks/LTX-2.3-fp8 | checkpoints |
gemma_3_12B_it_fp4_mixed.safetensors | 9,5 Go | Comfy-Org/ltx-2 | text_encoders |
ltx-2.3-spatial-upscaler-x2-1.1.safetensors | 1 Go | Lightricks/LTX-2.3 | latent_upscale_models |
Avec Stability Matrix : si vous utilisez les dossiers de modèles partagés, le checkpoint va dans Data/Models/StableDiffusion et l'encodeur Gemma dans Data/Models/TextEncoders. L'upscaler, lui, n'a pas de dossier partagé : déposez-le dans Data/Packages/ComfyUI/models/latent_upscale_models. Relancez ComfyUI ensuite pour qu'il voie les nouveaux fichiers.
Étape 2 : régler le template officiel
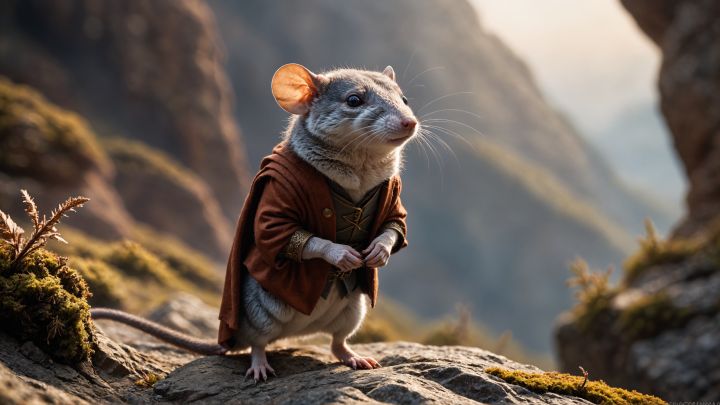
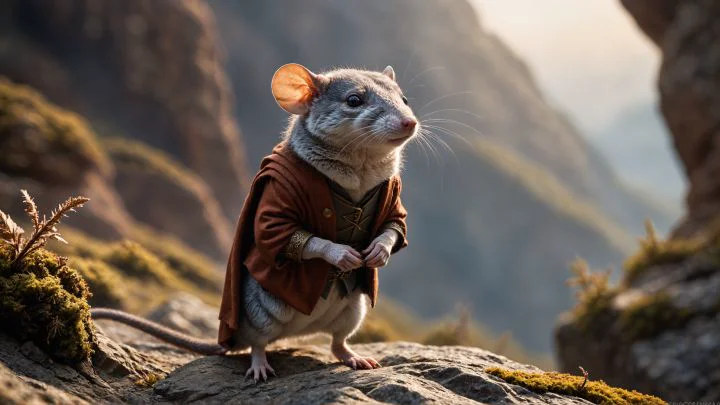
Le plus rapide : téléchargez mon workflow déjà réglé (modèle distillé, LoRA contourné, 8 pas, CFG 1, prompt et graine de la souris) et glissez le fichier JSON dans la fenêtre de ComfyUI. Placez l'image de départ dans le dossier input de ComfyUI, ou chargez-la dans le nœud Load Image.
Télécharger le workflow (JSON, 87 Ko) L'image de départ (JPG, 44 Ko)
Vous préférez partir de zéro ? ComfyUI fournit un template officiel, il suffit de le régler :
- Ouvrez Template Library, catégorie Video, puis LTX-2.3 I2V (image vers vidéo).
- Le template est prévu pour la version dev. Dans les trois loaders qui chargent le modèle (checkpoint, encodeur de texte, VAE audio), remplacez
dev-fp8parltx-2.3-22b-distilled-fp8.safetensors. - Bypassez le nœud LoRA distilled (clic droit puis Bypass, ou Ctrl+B). Il sert à rendre la version dev rapide ; avec le modèle déjà distillé, il ferait doublon.
- Vérifiez les réglages d'échantillonnage : 8 pas et CFG 1.
- Chargez votre image de départ, réglez la durée (en secondes) et gardez 25 images par seconde.
Le workflow travaille en deux temps : il génère d'abord la vidéo en demi-résolution, puis l'agrandit ×2 directement dans l'espace latent grâce à l'upscaler, avant de décoder l'image et le son. C'est ce qui permet de sortir du 720p (1280 × 704) sans exploser la mémoire.
Étape 3 : écrire un prompt qui marche
C'est l'étape qui fait la différence entre une vidéo molle et une scène qui raconte quelque chose. Les règles que j'ai retenues après mes essais :
- En anglais, même si le personnage parle français.
- Un seul plan, découpé en actions minutées :
0-2s: …,2-4s: …. Comptez une action toutes les 2 à 3 secondes. - Des verbes observables : « sprints », « leaps », « turns its head ». Pas d'intentions ni d'émotions abstraites.
- La caméra explicite : plan fixe, travelling, lent zoom avant. Sans consigne, le modèle improvise.
- Une lumière cohérente avec l'image de départ : même direction, même couleur.
- Une ligne
Audio: …à la fin, qui liste la voix, l'ambiance et les bruitages.
Le prompt de la souris
Voici le prompt exact de la vidéo du haut de page : oreilles dressées, réplique face caméra, sprint, saut entre deux rochers, puis pose héroïque face à la vallée.
The small mouse in a rust-colored cloak stands on the rocky mountain ledge at golden hour. 0-2s: its ears snap upright and it looks sharply to the right, whiskers twitching. 2-4s: it turns its head toward the camera and says in French, in a small, excited voice: "Tu as entendu ça ? L'aventure nous appelle !" 4-6s: it drops onto all fours and sprints along the ledge, its cloak flapping behind it, small pebbles bouncing off the rock. 6-8s: it leaps across a narrow gap to the next boulder, legs fully stretched in midair, and lands with a small skid, dust puffing around its paws. 8-10s: it rises on its hind legs at the edge, chest heaving, and gazes proudly over the misty valley as the wind lifts its cloak. The camera tracks smoothly alongside the mouse at its height, then slows and settles into a low hero angle at the end. Warm golden sunlight from the right, glowing rim light on its fur, mountains softly blurred in the background. Audio: the mouse's small clear voice, rushing mountain wind, tiny rapid footsteps on stone, pebbles clattering, a soft thud on landing, an eagle cry in the distance.Faire parler un personnage
LTX-2.3 sait faire parler un personnage en français, avec une synchronisation labiale correcte, si on respecte trois conditions :
- la réplique est entre guillemets ;
- elle tient en 6 à 8 mots pour 2 secondes de parole ;
- le personnage est immobile et face caméra pendant qu'il parle. Une réplique pendant une course donne une bouche approximative.
Close-up of the small mouse in a rust-colored cloak standing on the rocky mountain ledge. It turns its head toward the camera, its ears perk up, and it speaks in French with a small, determined voice: "La montagne est haute, mais mon courage aussi." Its mouth moves clearly with each word, whiskers twitching. A light breeze ruffles its fur and cloak. Warm golden hour light, misty mountains softly blurred in the background. Slow push-in toward its face, shallow depth of field. Audio: the mouse's small clear voice, soft wind, faint distant bird calls.Le squelette à réutiliser
Remplacez les crochets, gardez la structure :
The [subject exactly as seen in the image] stands [where], [time of day].
0-2s: it [one observable action].
2-4s: it turns toward the camera and says in French: "[6 to 8 words]"
4-6s: it [one observable action].
6-8s: it [one observable action].
The camera [explicit move: static shot / slow push-in / tracks alongside].
[Light matching the image: direction, color, mood].
Audio: [voice], [ambience], [sound effects].
Le piège : jamais de négation
Avec un CFG à 1, le modèle ne fait pas la différence entre « montre ceci » et « ne montre pas ceci » : chaque mot du prompt ajoute son concept à l'image. Écrire no text fait donc apparaître du texte. Décrivez toujours ce que vous voulez voir (« a clear blue sky ») plutôt que ce que vous ne voulez pas (« no clouds »).
Les temps de génération mesurés
Mesures en 720p à 25 images par seconde, sur la config ci-dessus :
| Durée de la vidéo | Temps de génération | Pic de RAM |
|---|---|---|
| 5 secondes | ≈ 3 min | ≈ 60 à 62 Go |
| 10 secondes | ≈ 4 min 20 | |
| 15 secondes | ≈ 5 min 50 |
- Le premier rendu après le lancement de ComfyUI prend environ 1 minute de plus, le temps de charger les modèles en RAM.
- Une partie de ces mesures a été faite avec une variante un peu plus lourde du même modèle. Avec le modèle officiel, comptez autant, voire un peu moins.
- Le temps ne double pas quand la durée double : une bonne partie du coût est fixe (encodage du prompt, chargement, décodage).
Ce qui n'a pas marché : 12 i/s et interpolation
Pour gagner du temps, j'ai essayé de générer à 12 images par seconde puis d'interpoler à 24 avec RIFE. Le résultat est à éviter : les mains deviennent étalées et floues dès que le personnage bouge vite.
On pourrait croire que c'est la même chose que la Frame Generation du DLSS dans les jeux. Ce n'est pas le cas, pour deux raisons :
- Dans un jeu, le moteur fournit les vecteurs de mouvement exacts de chaque pixel. L'IA n'a rien à deviner sur la direction des objets. RIFE, lui, doit estimer le mouvement à partir de deux images seulement.
- La Frame Generation part d'environ 60 i/s : entre deux images, il s'écoule 16 ms et presque rien ne bouge. À 12 i/s, il s'écoule 83 ms, et une patte ou une main a le temps de changer complètement de forme. C'est précisément là que l'estimation casse.
Conclusion : générez directement à 25 i/s. Le surcoût en temps est réel, mais le résultat est propre.
Pour aller plus loin
- LTX-2.5, sorti en août 2026, annonce lui aussi 16 Go de VRAM, mais ComfyUI recommande 32 Go. À tester avec prudence sur une carte de 16 Go.
- Les versions NVFP4 de LTX-2.3 : les cartes Blackwell (série RTX 50) accélèrent nativement le calcul en FP4. C'est la prochaine piste pour réduire les temps sur ce type de carte.
Questions fréquentes
LTX-2.3 tourne-t-il vraiment avec 16 Go de VRAM ?
Oui, en version distillée FP8, grâce au chargement dynamique de ComfyUI qui garde le modèle en RAM. La VRAM reste pleine pendant tout le rendu : c'est le fonctionnement attendu, pas un problème.
32 Go de RAM suffisent-ils ?
Non. Le modèle et l'encodeur de texte pèsent à eux seuls près de 40 Go, et j'ai mesuré un pic de RAM autour de 60 Go. Il faut 64 Go.
Le son est-il ajouté après coup ?
Non, c'est tout l'intérêt de LTX-2.3 : l'image et le son sont générés ensemble, dans le même passage. Les bruitages tombent donc au bon moment, et la bouche suit la réplique.
Peut-on partir d'un texte au lieu d'une image ?
Oui, la Template Library propose aussi un template texte vers vidéo (T2V), qui se règle de la même façon. Partir d'une image donne toutefois bien plus de contrôle sur le personnage et le décor.